40MB 的浏览器,凭什么敢和 Chrome 掰手腕?| 旋武社区 Rust 开源项目推荐
发表于:2026-09-16
Rust 新闻
摘要
Moli 是一款用 Rust 编写的开源命令行浏览器,整个程序只有 40MB,支持 Linux、macOS 和 Windows。它把网页加载、JavaScript 执行、数据提取、截图和自动化控制全部集成在一个二进制文件里——像 curl 或 jq 一样,直接接入你的脚本、管道和 AI Agent 工作流。
抓网页、跑脚本、做自动化,一定要先装一整套 Chrome 吗?旋武社区今天推荐的这个 Rust 项目,想给你一个新答案。
先想象一个场景
你只想从 Hacker News 上抓几条新闻标题,输出成 JSON,交给下游脚本处理。
为此,你启动了 Chrome,等它加载完一堆你用不到的 UI 组件、字体、渲染管线,然后才执行你的提取逻辑。任务完成了,但你的内存也被吃掉了一大块。
这件事,本不该这么重。
Moli 是一款用 Rust 编写的开源命令行浏览器,整个程序只有 40MB,支持 Linux、macOS 和 Windows。它把网页加载、JavaScript 执行、数据提取、截图和自动化控制全部集成在一个二进制文件里——像 curl 或 jq 一样,直接接入你的脚本、管道和 AI Agent 工作流。
核心思路:结构优先,按需生成画面
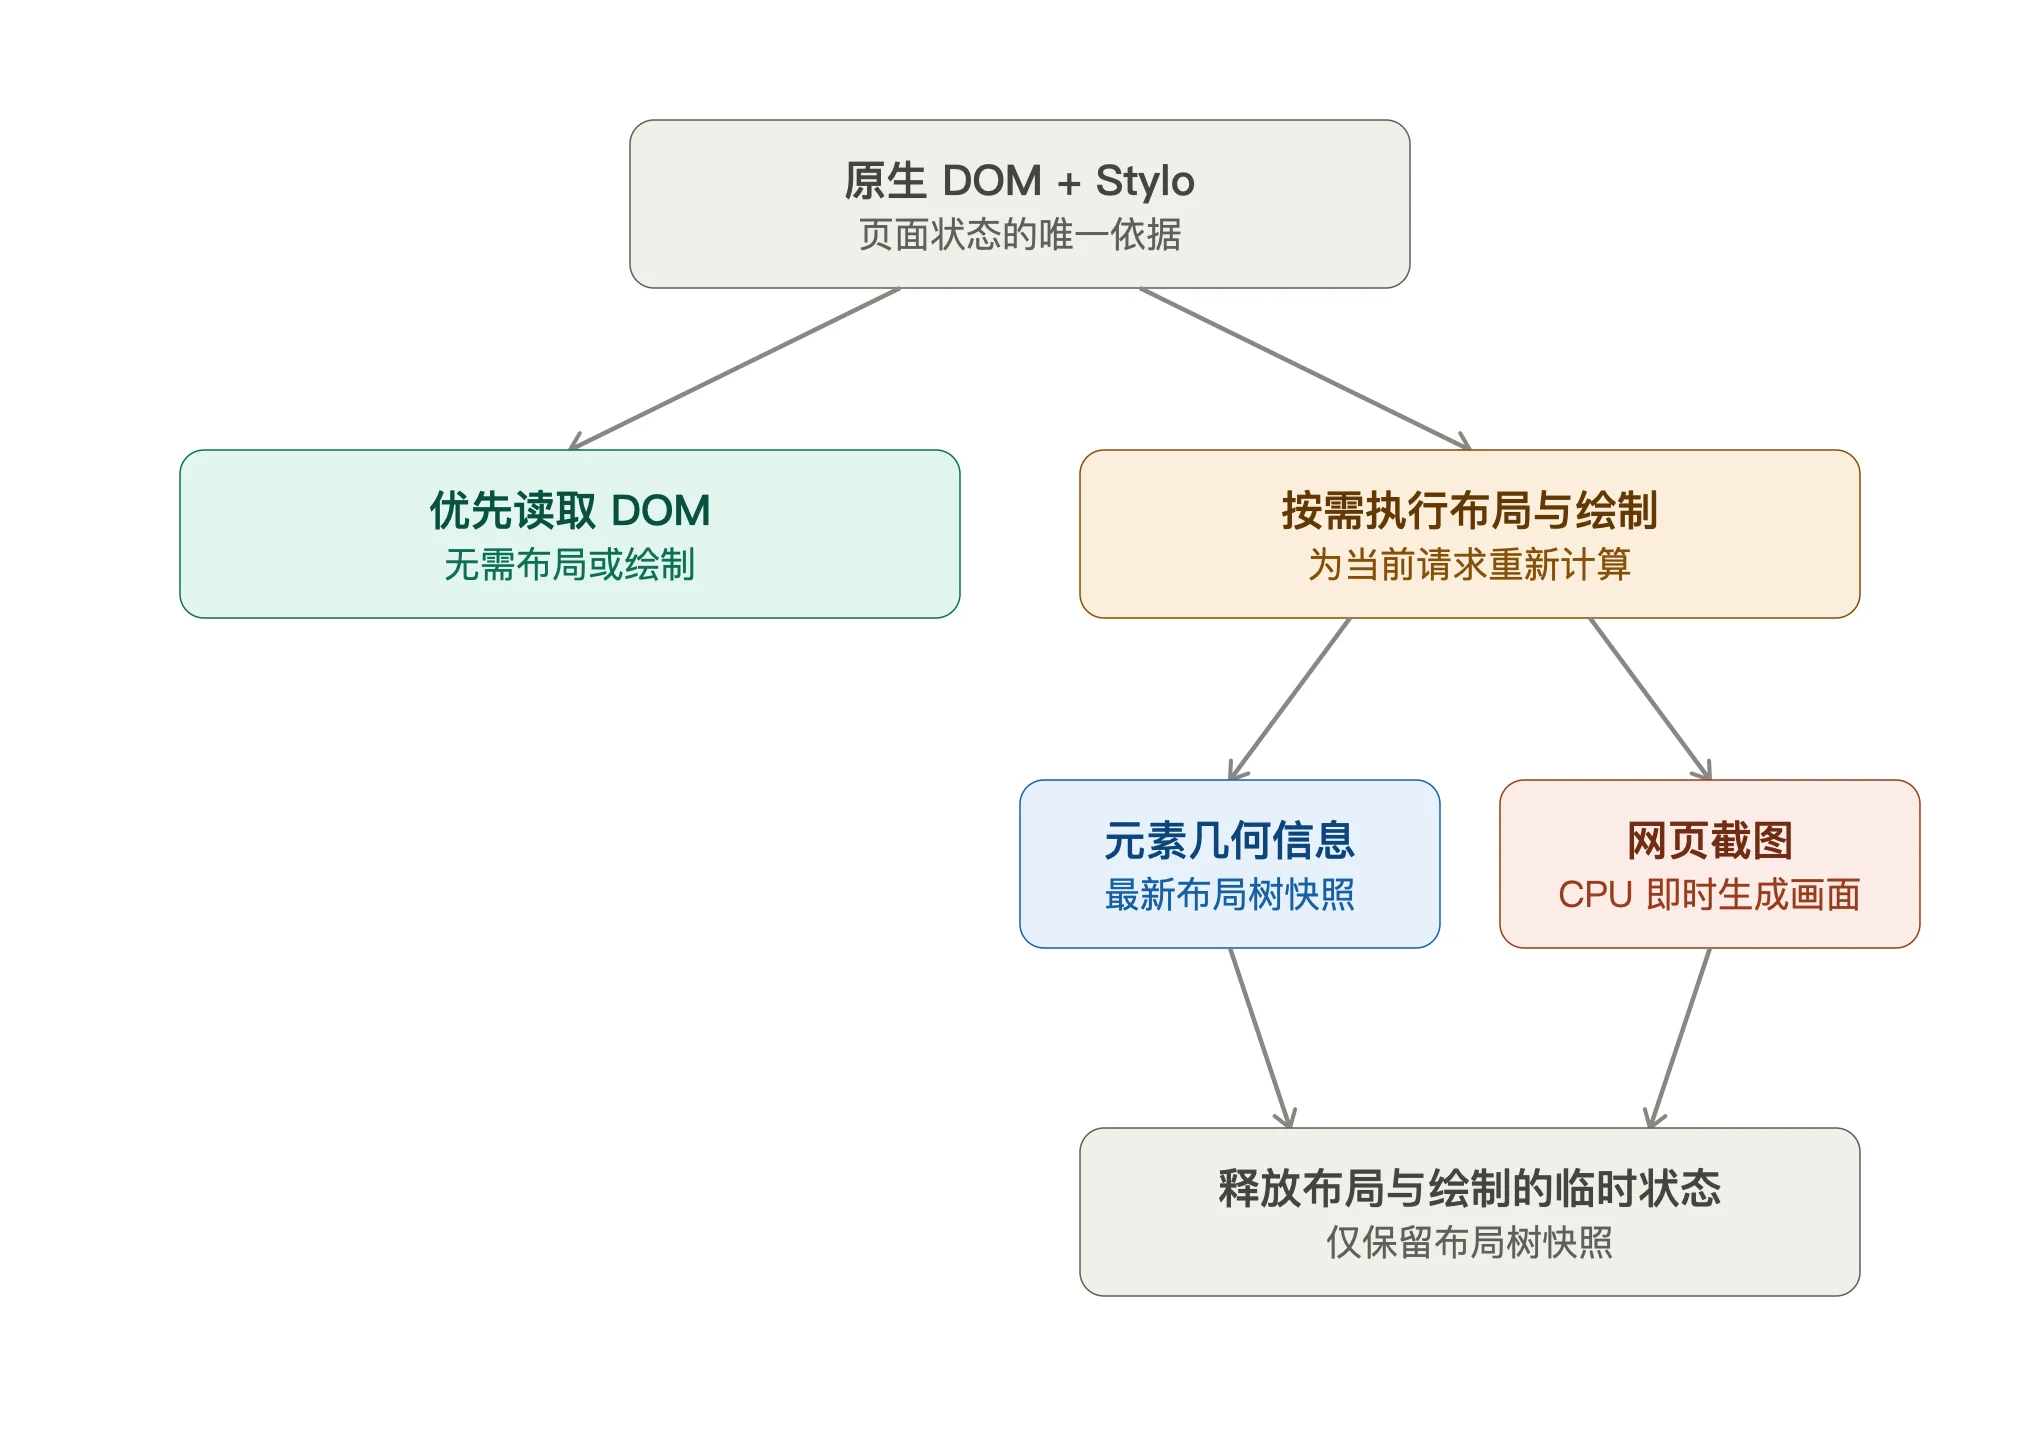
传统浏览器是为人类交互设计的:滚动、动画、页面变化,都需要随时准备呈现。为了快速更新画面,渲染管线会保留大量布局和绘制的中间缓存。 但抓取程序和 AI Agent 的需求完全不同——
- 提取新闻标题时,并不需要知道每个字在屏幕上的坐标。
- 读取表单状态时,也不一定需要先生成一张截图。
Moli 因此把“运行网页”和“生成画面”分开处理:
- 查询 DOM、执行脚本、提取文本时,不执行真实布局和绘制;
- 需要元素位置、坐标交互或截图时,再按需启动相应计算;
- 绘制用完后,不长期保留整套绘制状态。
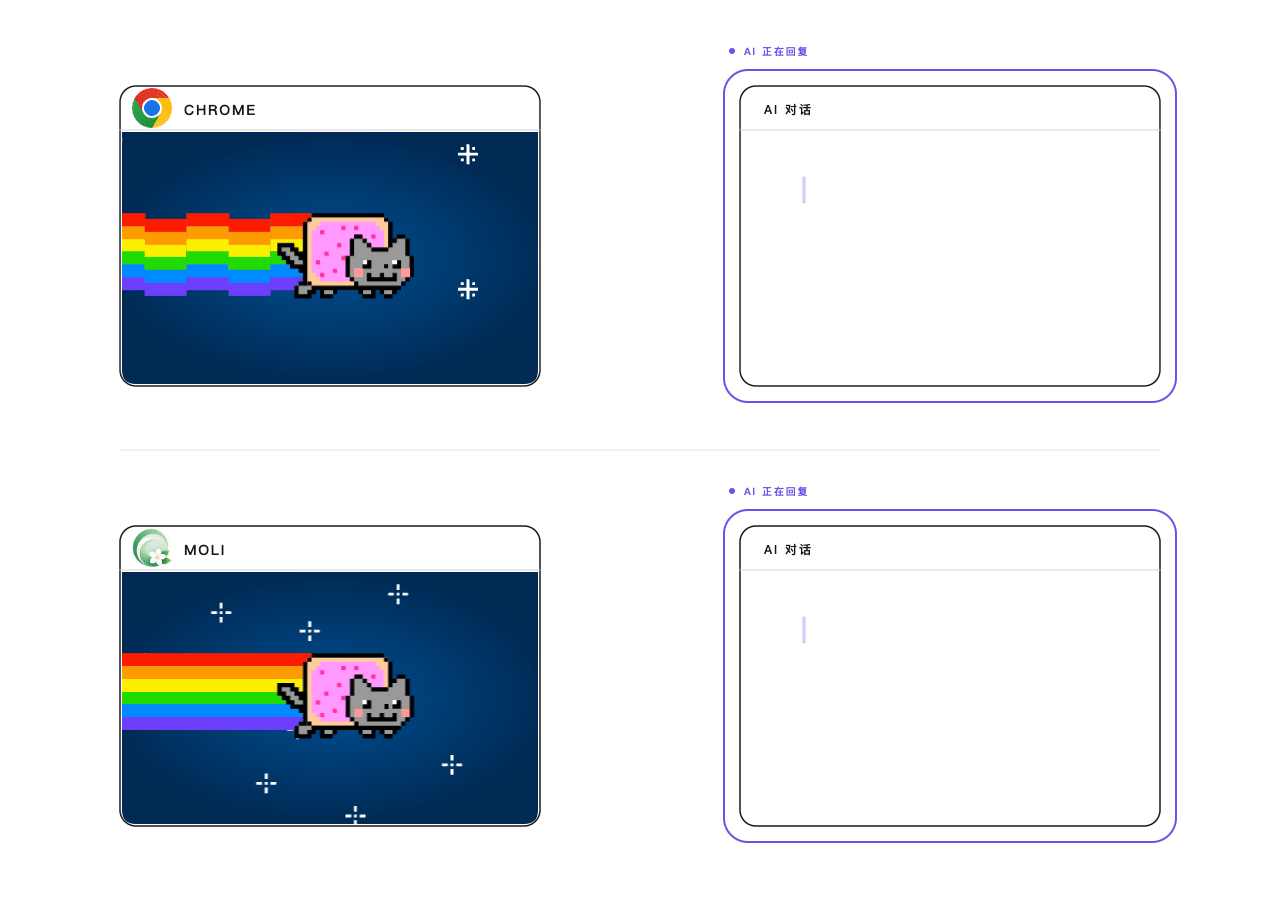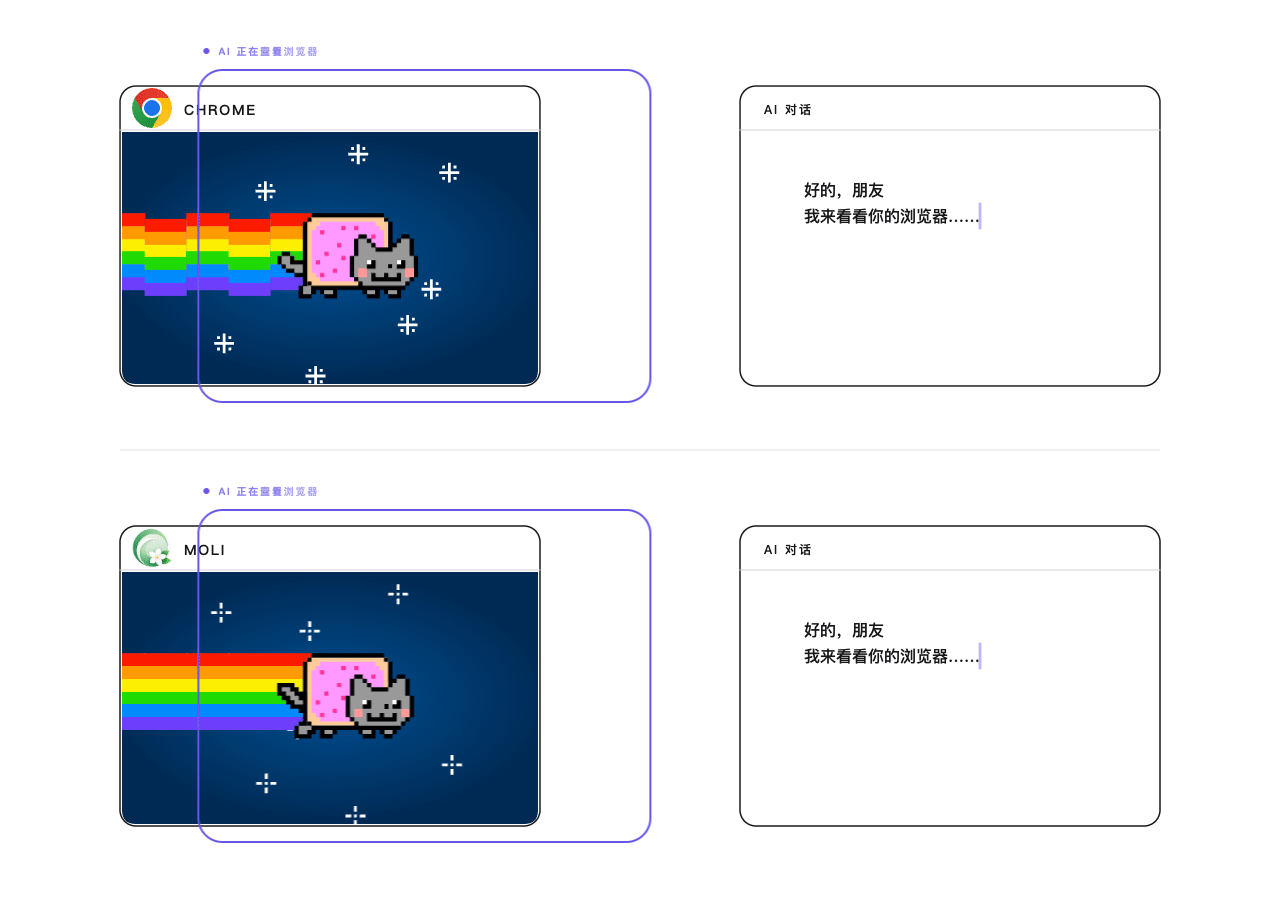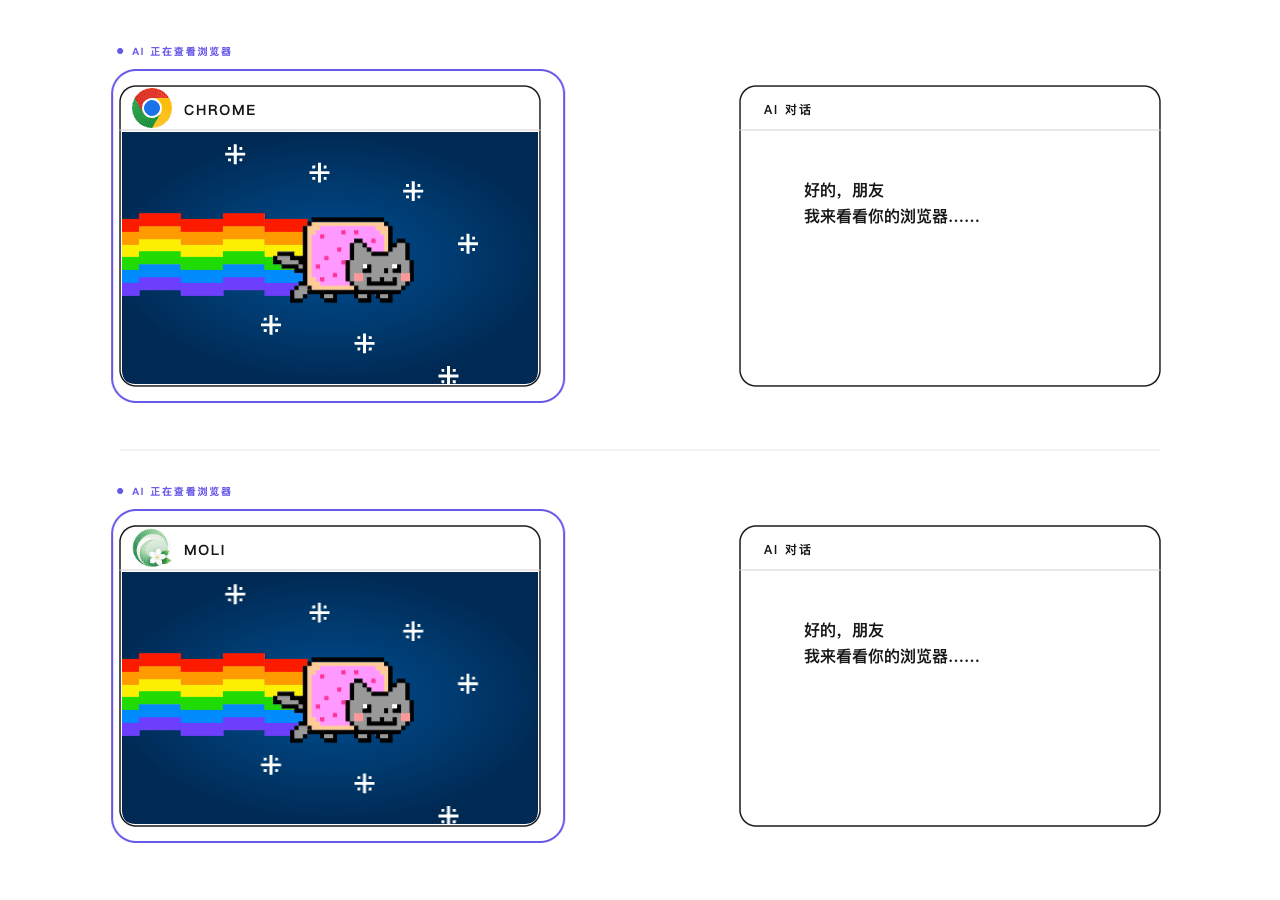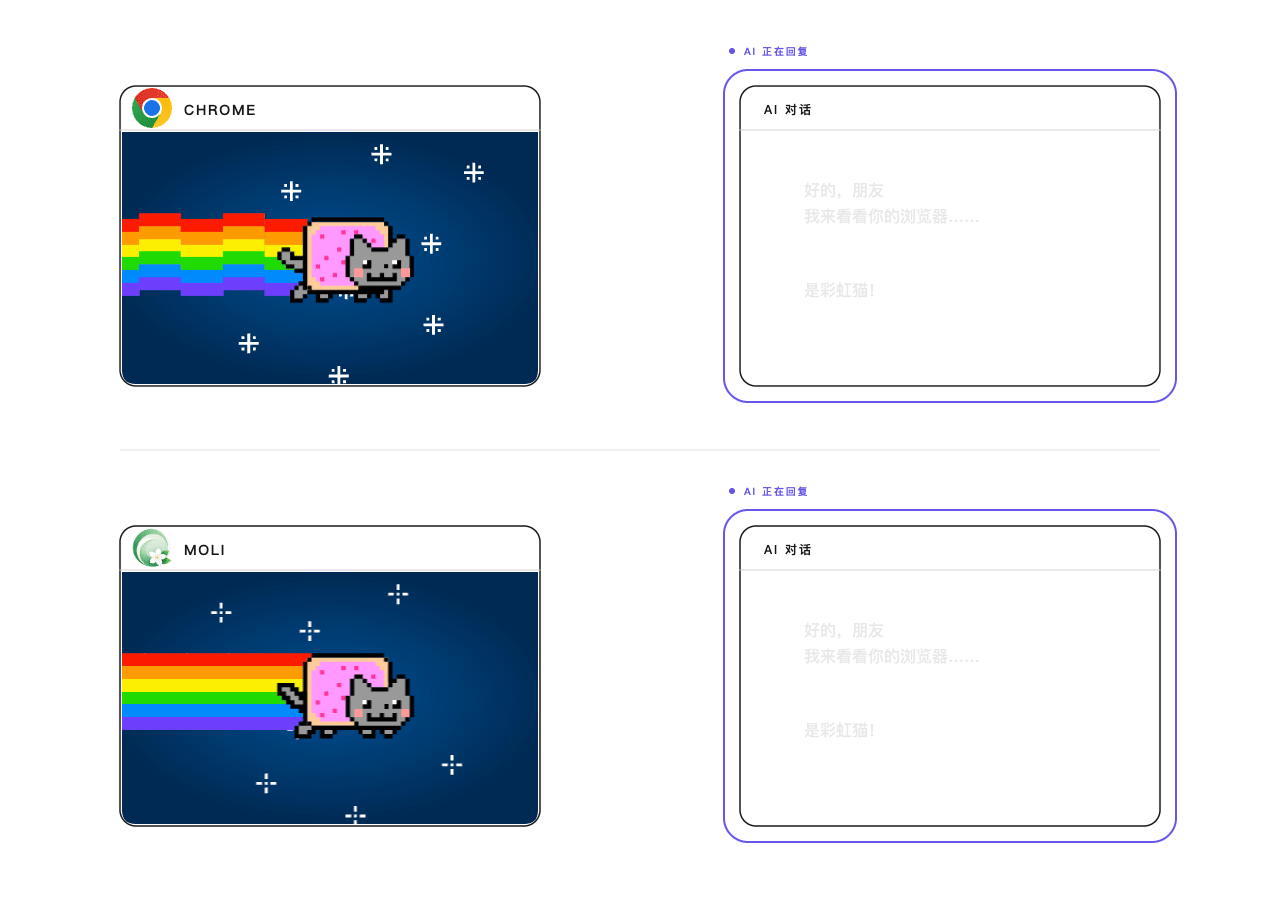
效果如何?内存占用仅需 Chrome 的 1/7,CPU 占用仅需 Chrome 的 2/3。
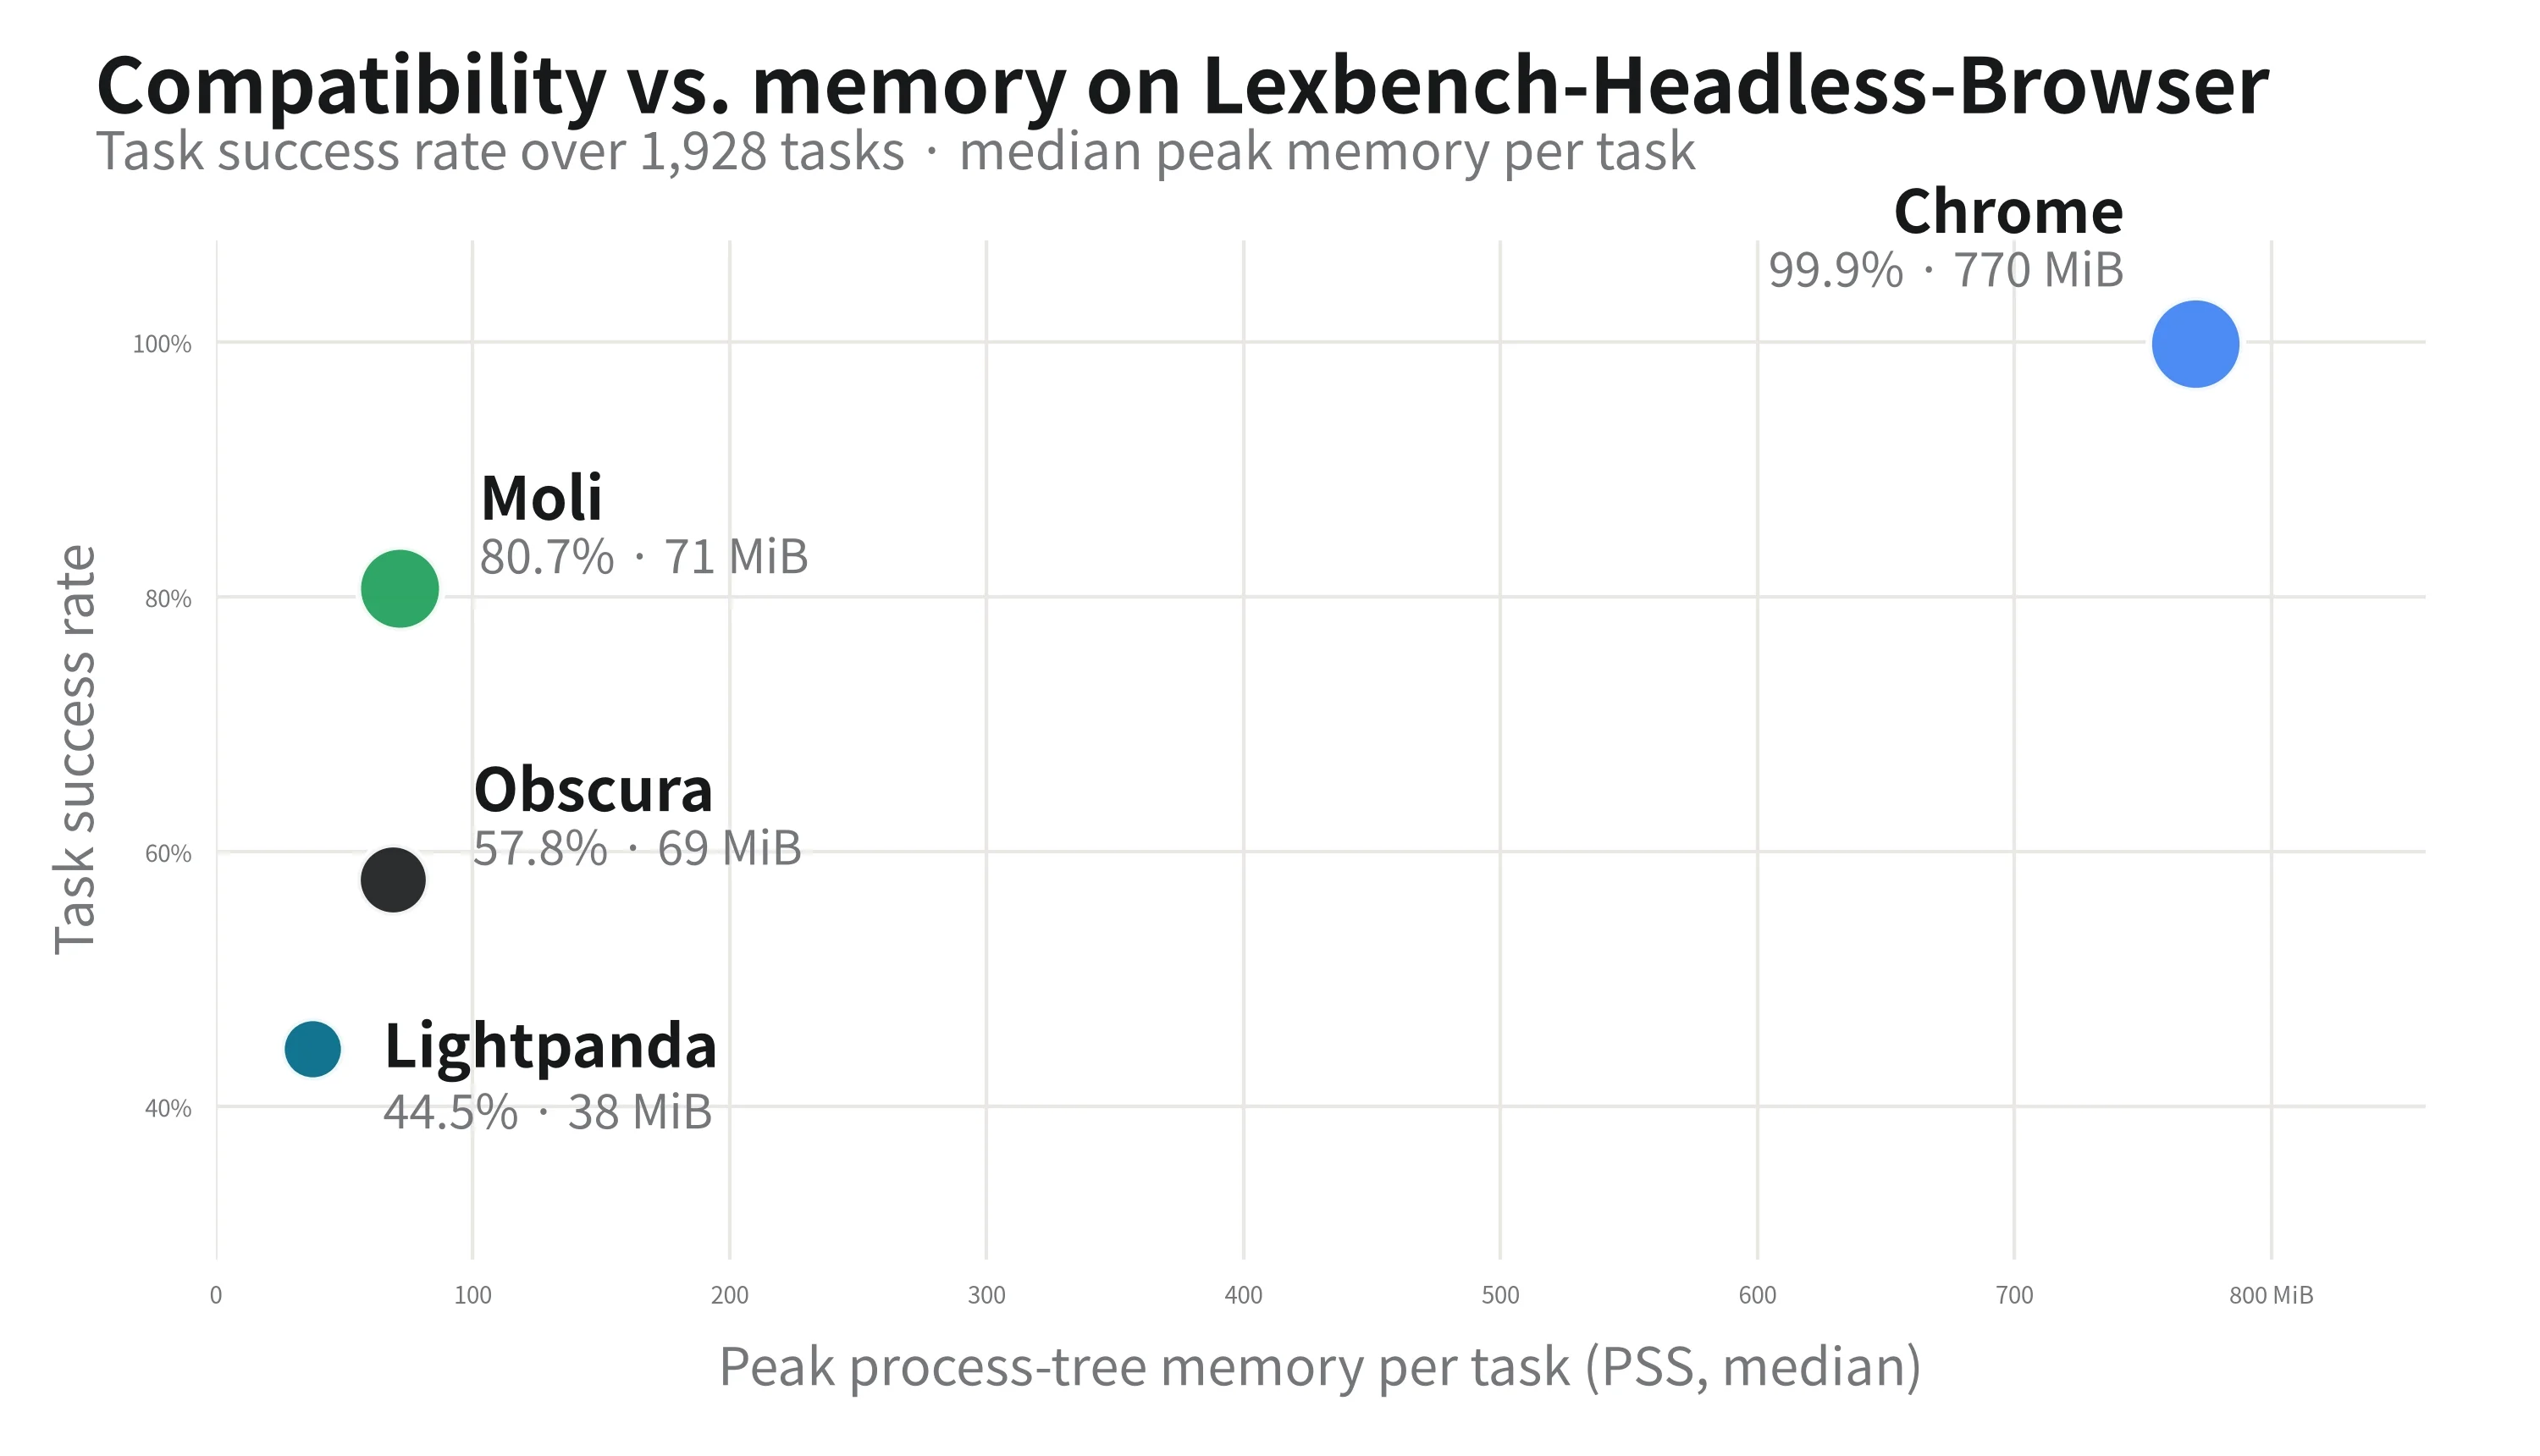
来源:https://github.com/lexmount/Lexbench-Headless-Browser
轻,但不弱
一个浏览器再省资源,如果目标页面打不开、脚本跑不起来,终究无法完成任务。
Moli 内置 V8 JavaScript 引擎,实现了 DOM、CSS、网络和存储等浏览器能力,支持 iframe、Worker、Cookie、WebCrypto、IndexedDB 等特性。动态内容可以生成,自动化任务可以顺利操作页面。
在项目用于验证 Agent 浏览器能力的 WPT 选定测试集中,Moli 完整运行通过了约 161 万项测试。
在公开的五引擎 CDP 任务能力对比中,按 1,308 项可比网页自动化任务统计,Moli 的任务通过率为 81.9%,高于 Kitesurf 的 62.1%、Lightpanda 的 53.3% 和 Obscura 的 44.9%;作为参照的 Chrome 为 99.8%。
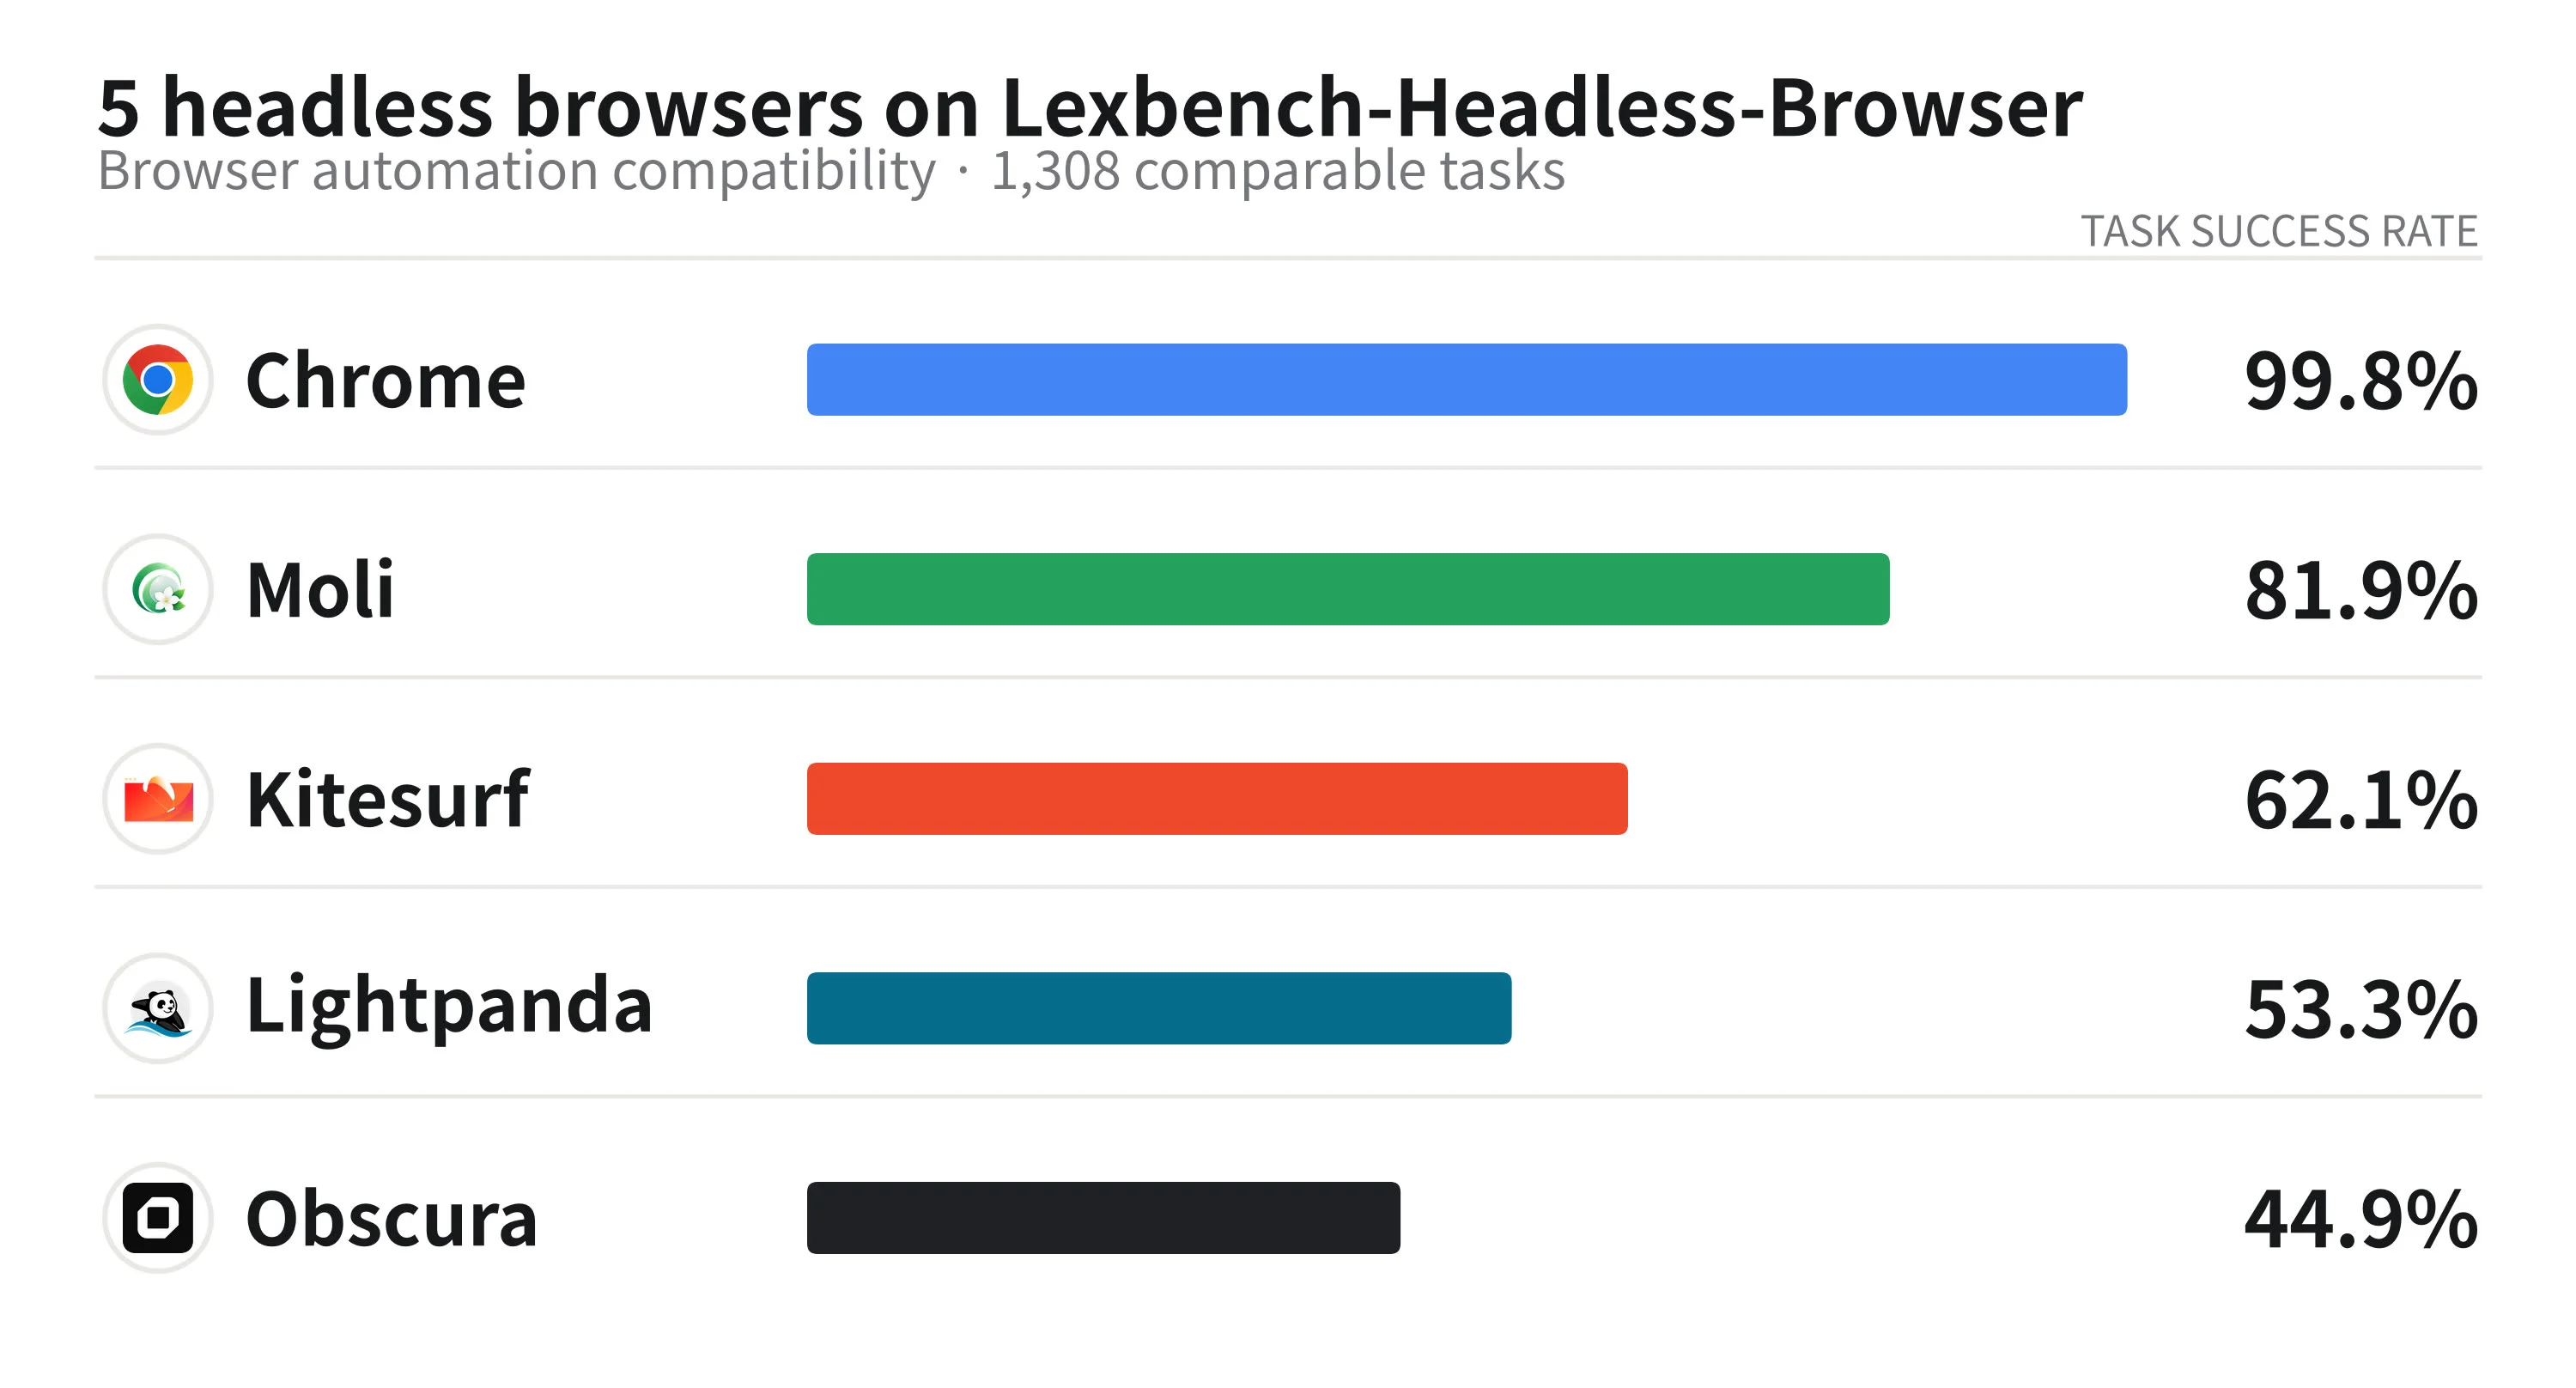
来源:https://github.com/lexmount/Lexbench-Headless-Browser
保持较低资源开销的同时,尽可能覆盖真实网页与自动化工具所需的能力——这就是 Moli 的设计取舍。
三个例子,看它怎么走进命令行
例一:在终端里渲染 Hacker News
启用布局与资源加载后,Moli 可以生成网页截图,并通过终端图片工具直接显示:
moli fetch https://news.ycombinator.com/news \
  --layout --resource \
  --dump screenshot | kitten icat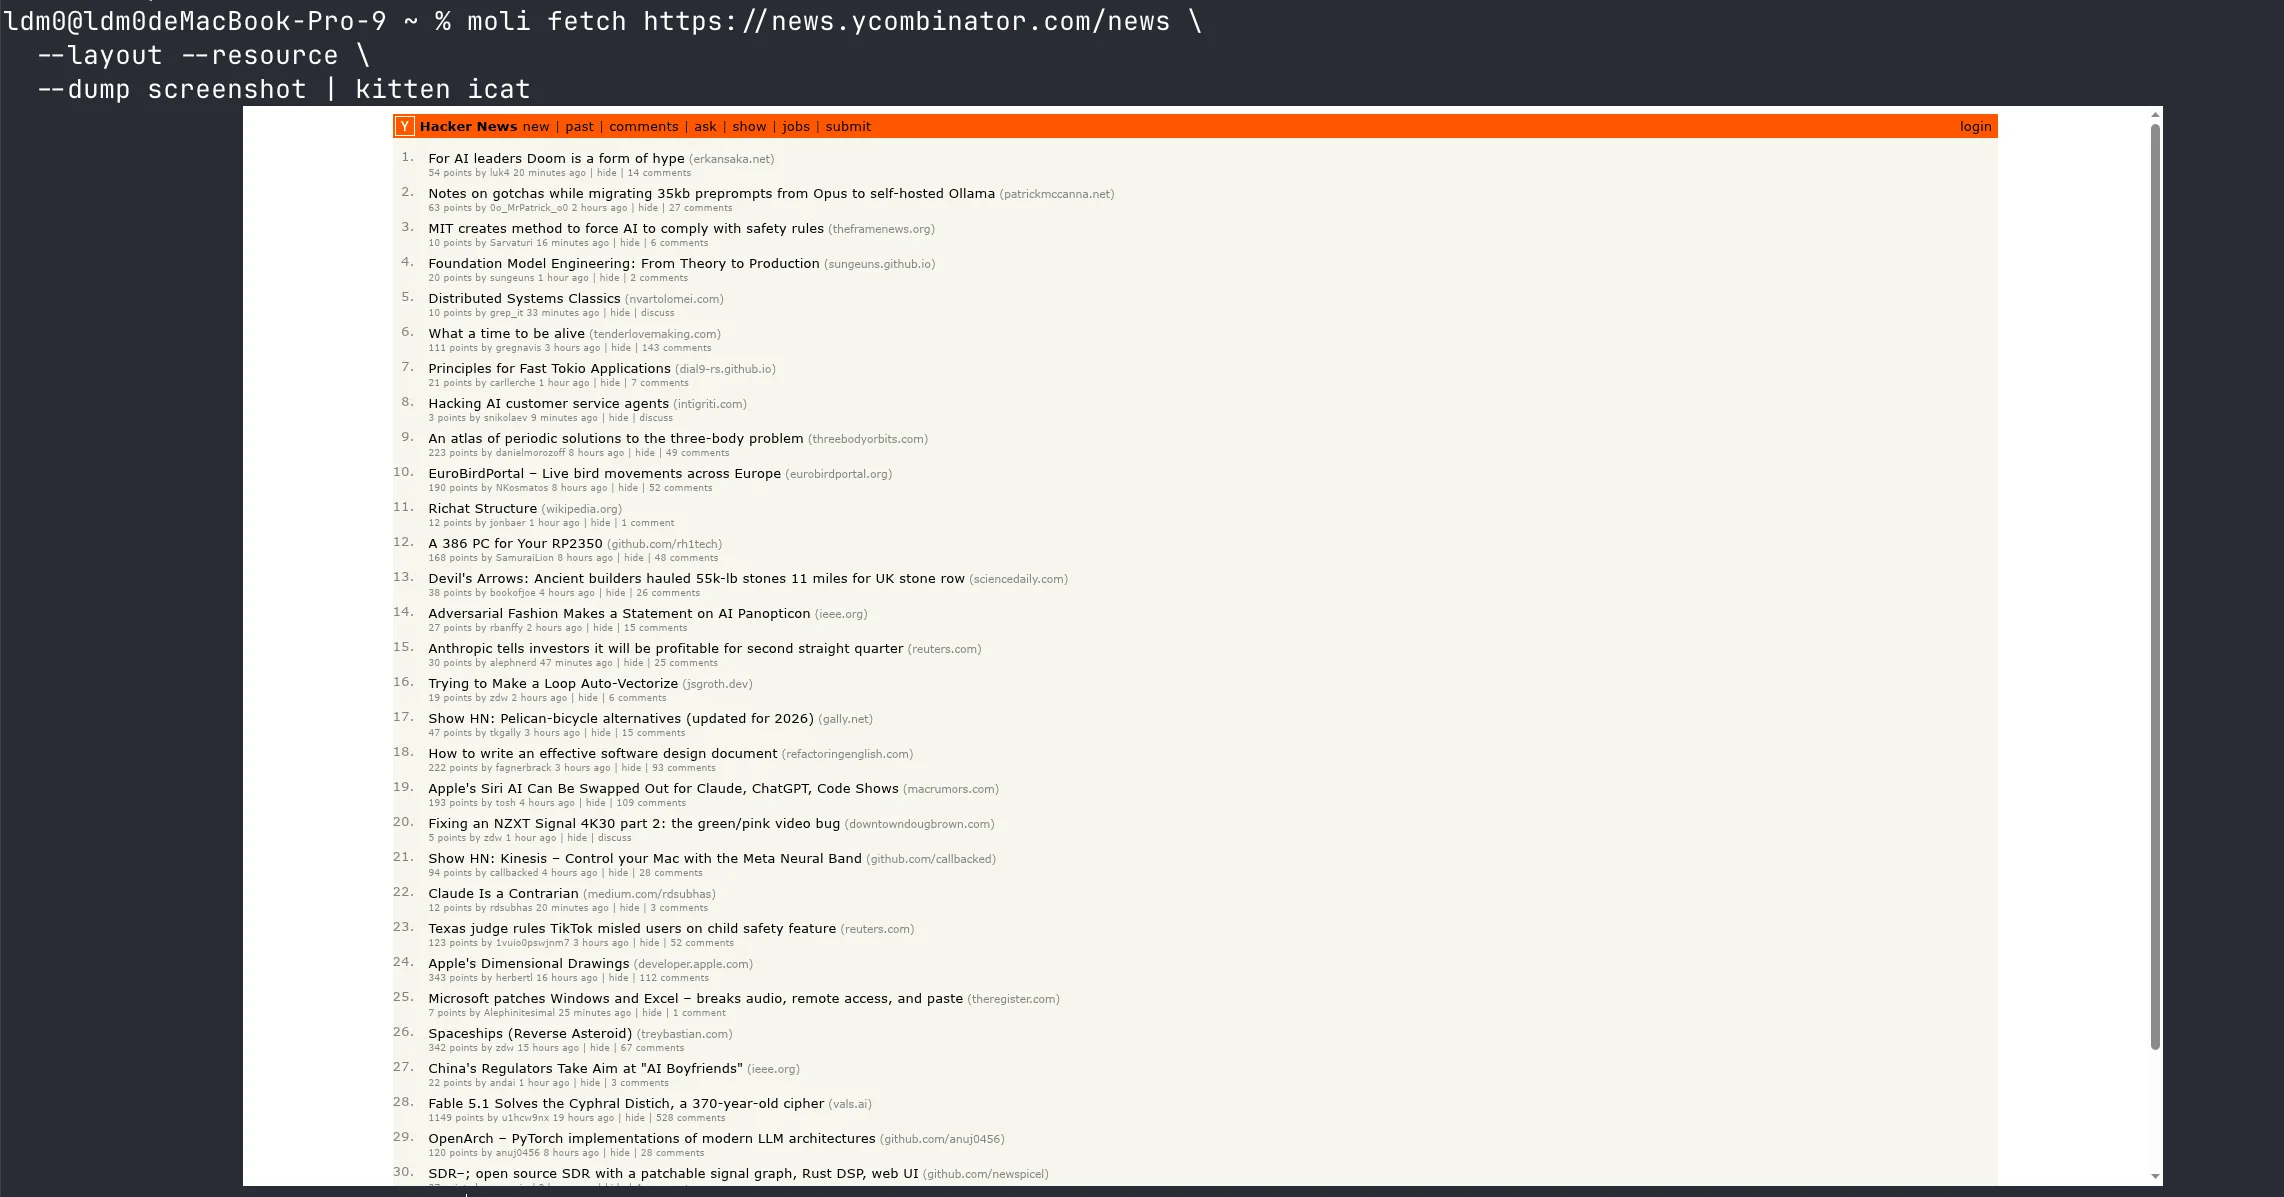
这里,网页由 Moli 加载和渲染,kitten icat 负责显示输出的图片。去掉管道,改为 > hn.png,就可以把截图保存为文件。不需要打开一个浏览器窗口。
例二:直接把新闻提取成 JSON
只需要数据时,跳过截图,在加载完成的页面中执行 JavaScript:
moli fetch --wait-until done --eval '
(() => {
  return [...document.querySelectorAll("tr.athing")]
    .slice(0, 8).map((tr, i) => {
      const a = tr.querySelector(".titleline a");
      const sub = tr.nextElementSibling;
      return {
        rank: i + 1,
        title: a?.textContent,
        href: a?.href,
        site: tr.querySelector(".sitestr")?.textContent,
        score: sub?.querySelector(".score")?.textContent,
        user: sub?.querySelector(".hnuser")?.textContent
      };
    });
})()
' https://news.ycombinator.com/ | jq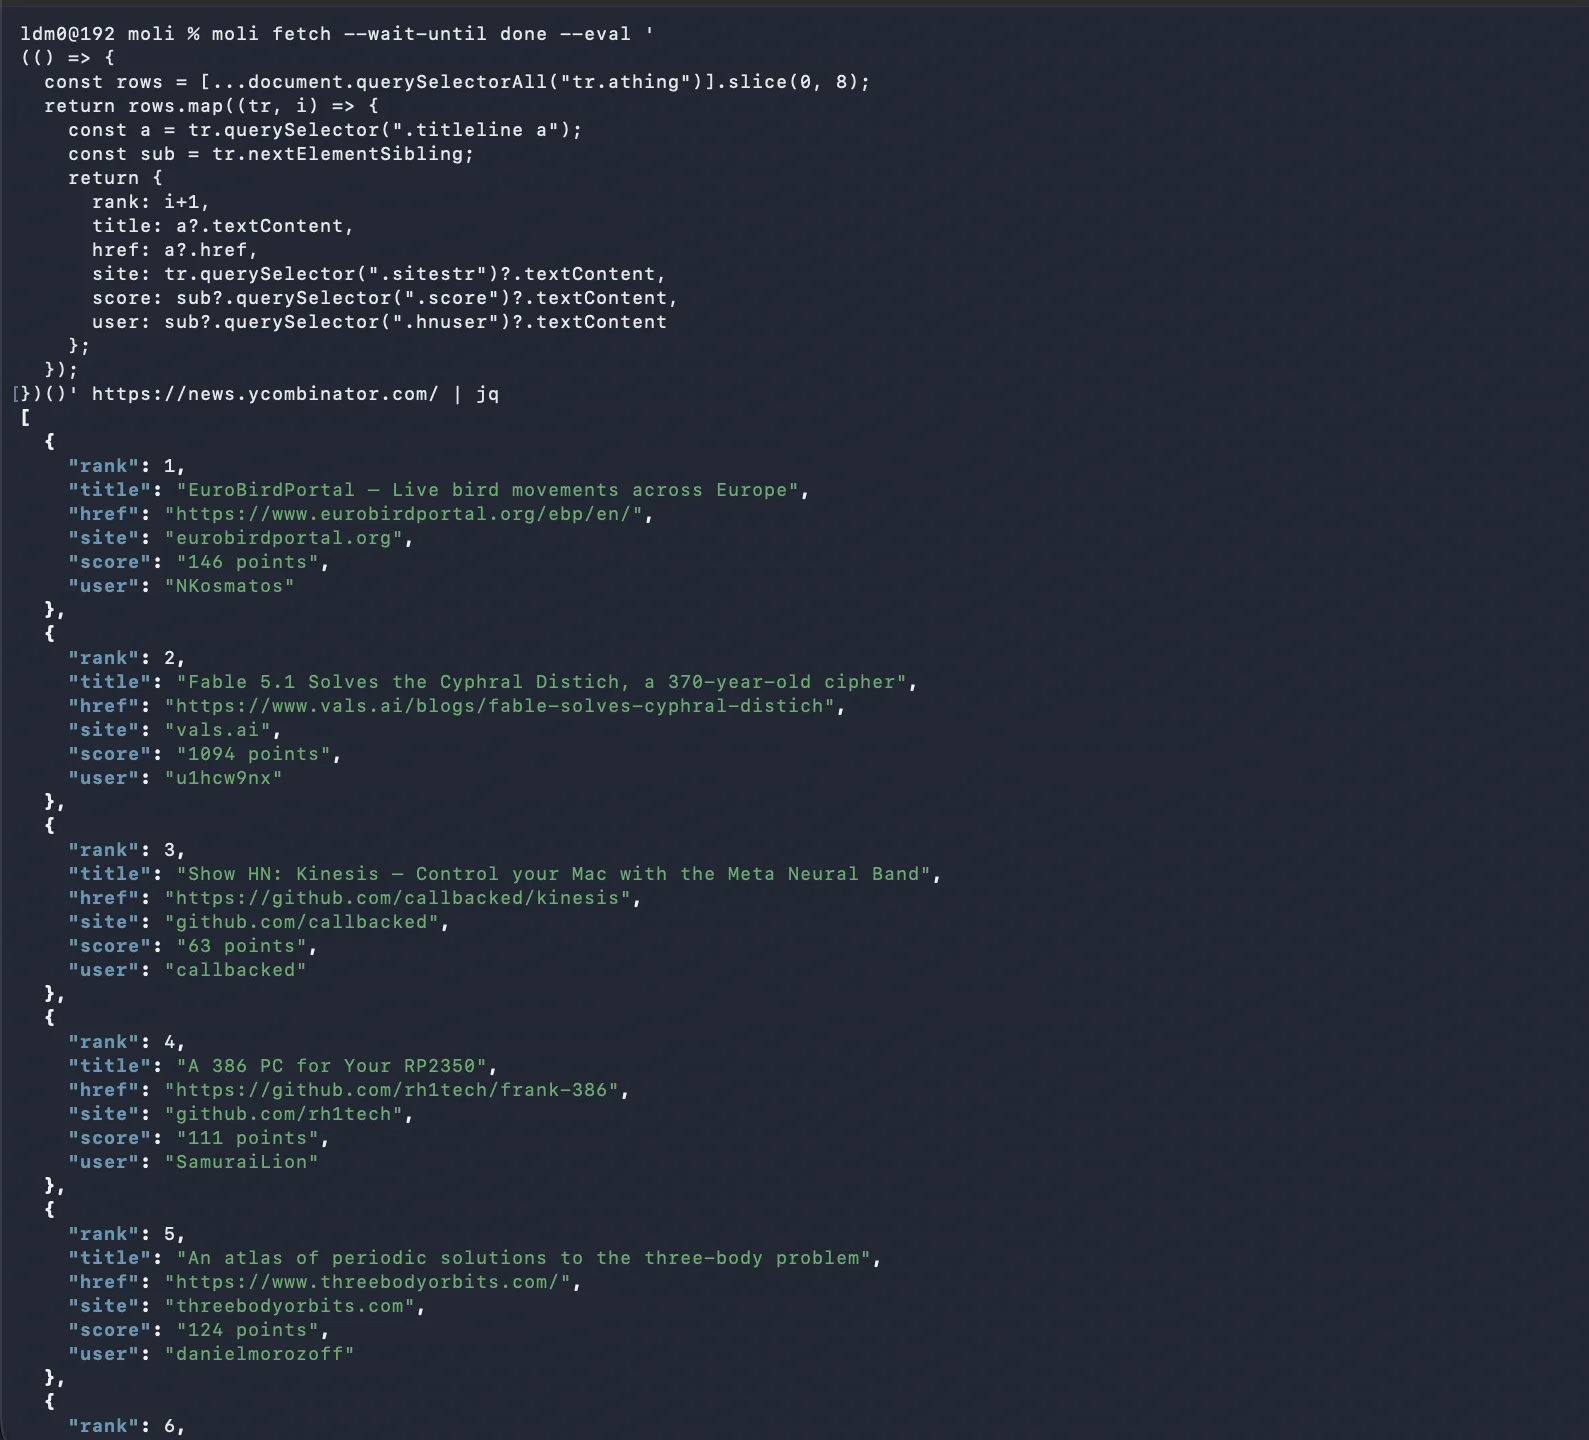
加载网页 → 执行提取逻辑 → 输出 JSON,结果直接交给 jq 继续处理。无需为这样一个提取任务,单独搭建自动化脚本工程。
例三:渲染 Canvas 并响应交互
Moli 还能运行 HTML5 格斗游戏,涉及 Canvas 绘制、动画回调和键盘输入,并可通过 Chrome DevTools 查看运行状态。
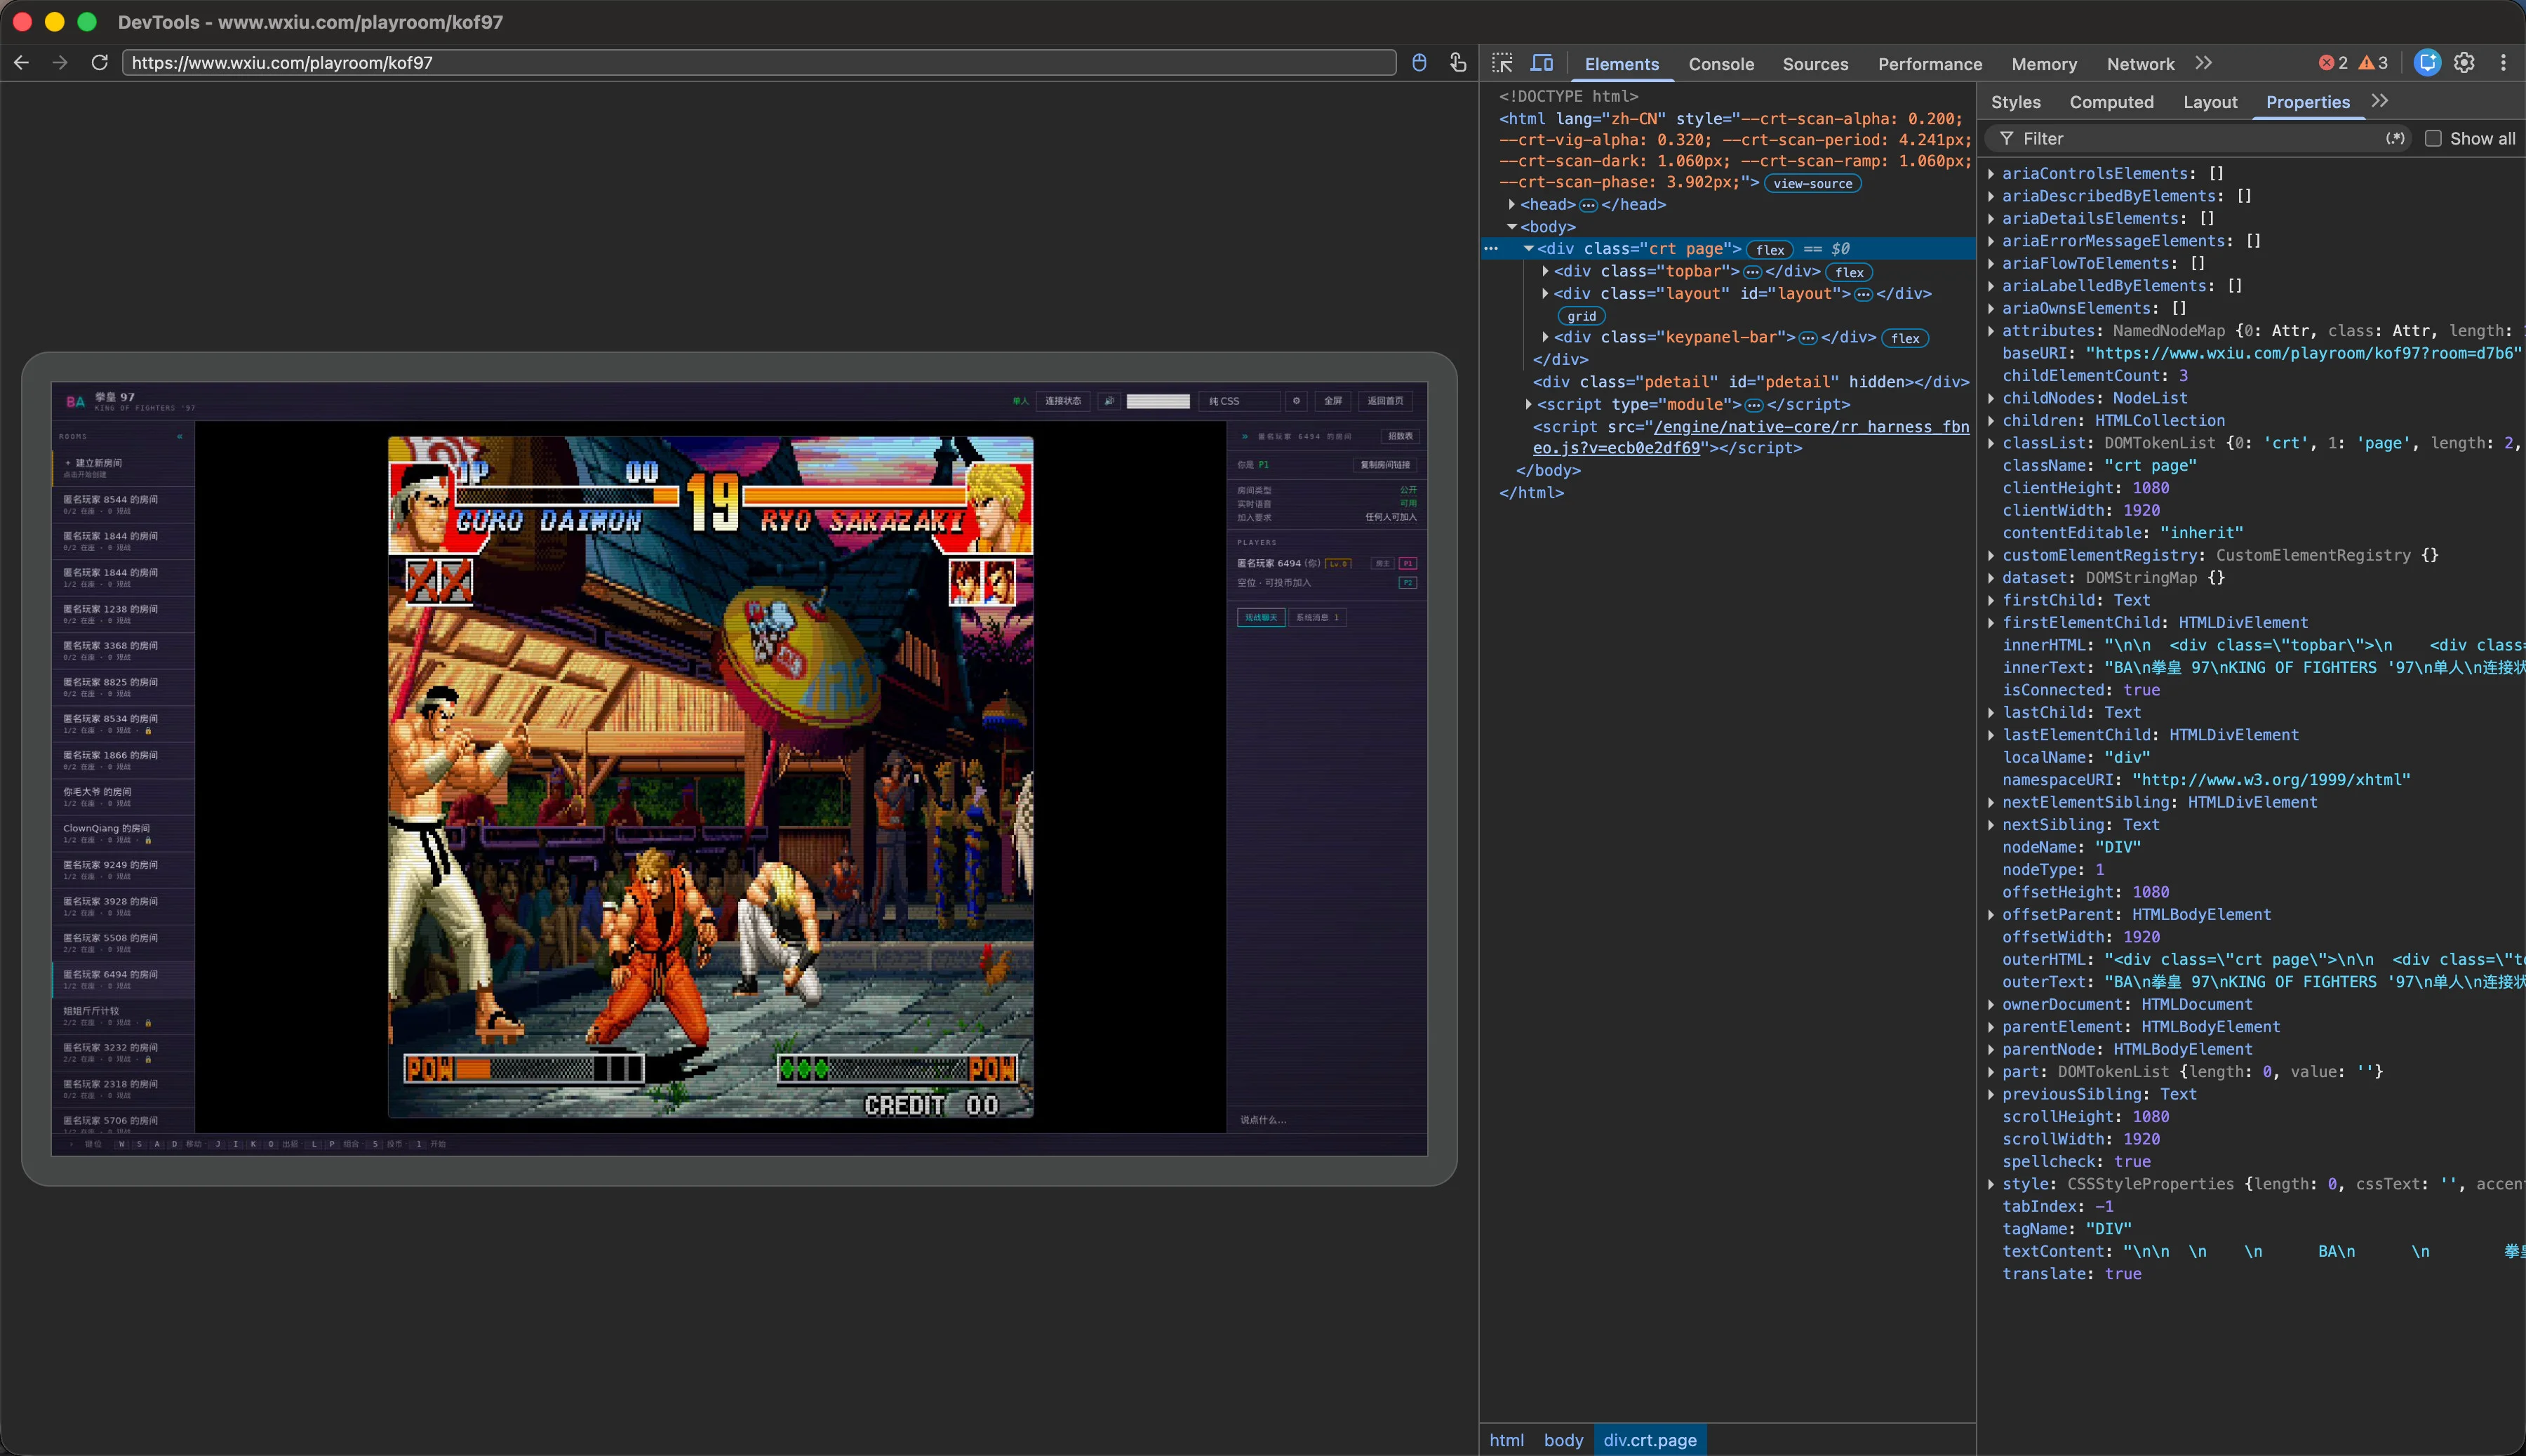
Chrome DevTools 是调试前端,真正执行页面脚本、响应输入并生成画面的是 Moli。
接入你已有的自动化工具
除了直接执行命令,Moli 也能作为浏览器自动化服务运行:
moli serve --layout同一个服务端点支持 CDP、WebDriver Classic 和 WebDriver BiDi,可供 Playwright、Puppeteer、Selenium 等工具连接,不需要再额外安装 ChromeDriver 或 geckodriver。
对开发者而言,可以保留熟悉的自动化工具,在现有流程中评估和引入 Moli。 对 AI Agent 而言,既可以直接调用 CLI,也可以通过浏览器控制协议完成多步骤操作。
用 Rust 构建,也受益于 Rust 生态
Moli 复用了多项成熟的基础组件:
- HTML 解析:html5ever
- CSS 处理:servo/stylo
- 布局与文本排版:taffy、parley
- 软件渲染:anyrender、vello_cpu
- JavaScript:deno/rusty_v8 接入 V8
Rust 在这里不仅是实现语言,也提供了组织复杂浏览器状态、表达所有权和管理资源生命周期的工具。
对于 Rust 开发者,Moli 是一个贯穿网络、DOM、脚本、布局和绘制的工程实例——既可以看到成熟生态组件如何协同工作,也可以从具体的网页兼容性问题入手参与贡献。
快速开始
访问 https://xuanwu.openatom.org/articles/project/moli 获取 Moli 二进制。
项目还提供了 Agent skills,便于 AI 智能体安装和使用,涵盖:
- 网页抓取
- 文字图片搜索
- 网页自动化
写在最后
Moli 的目标是让抓取程序、自动化工具和 AI Agent 以更低的成本使用互联网:
- 需要内容,就提取内容;
- 需要画面,再生成画面;
- 需要自动化,则用已有工具直接接入。
想了解更多设计和技术细节,可以查看: https://browser.lexmount.cn/blog/moli-ai-browser
欢迎从一个网页、一段提取脚本开始体验 Moli,提交兼容性问题,或参与代码与测试贡献。
项目仓库:https://xuanwu.openatom.org/articles/project/moli
如果这个项目让你眼前一亮,欢迎转发给身边做爬虫、自动化或 AI Agent 的朋友。Rust 浏览器的更多可能,我们一起探索。
旋武开源社区:https://xuanwu.openatom.org
致力于在中国普及和发展 Rust 编程语言,培育中国 Rust 专家,繁荣 Rust 生态